第 1 天复盘
第 1 天复盘
日期:2026-09-10
今日目标
- [ 建立学习基线与资料索引]
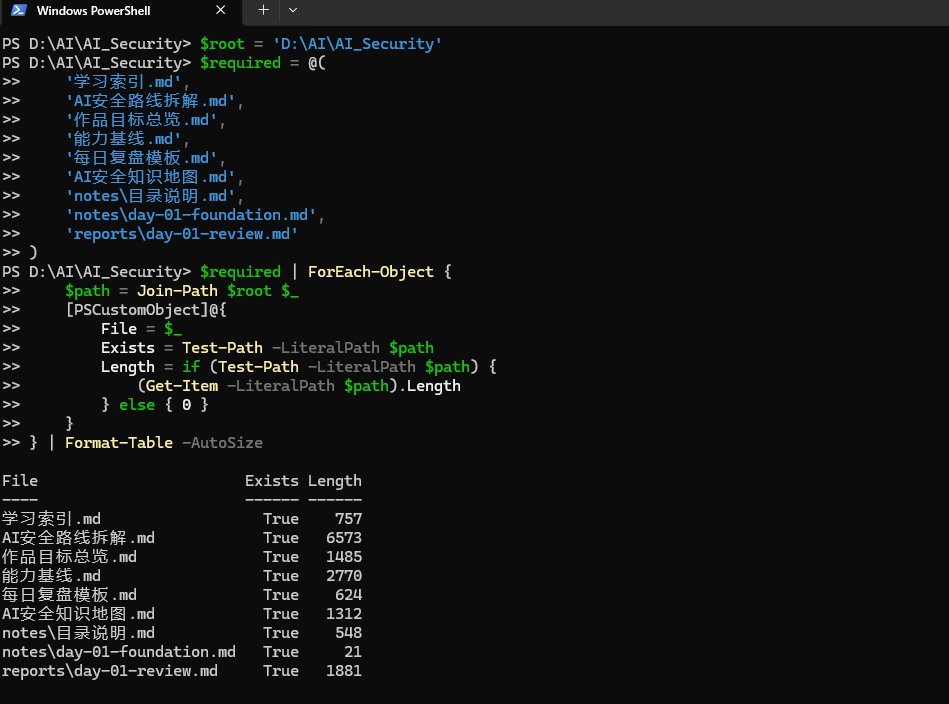
完成证据
- 文件:’学习索引.md’,
‘AI安全路线拆解.md’,
‘作品目标总览.md’,
‘能力基线.md’,
‘每日复盘模板.md’,
‘AI安全知识地图.md’,
‘notes\目录说明.md’,
‘notes\day-01-foundation.md’,
‘reports\day-01-review.md’ - 命令输出:
核心概念
- 概念:RAG(检索增强生成)
- 我的解释:通过给文本加上向量标签的方式来让模型输出时可以达到类似“考试翻阅资料”的效果,整理后进行回答,输出更精准
- 与 AI 安全的关系:检索增强生成(RAG)是提升AI回答质量的核心架构,了解并学习RAG有助于减少幻觉生成、提高透明度、减少偏见
实验记录
- 场景:个人能力自评
- 输入:依照评分标准进行自评
- 环境:
Typora - 现象:路漫漫其修远兮
- 结论:吾将上下而求索
今日卡点
- 卡点:对一些AI的专业术语尝试进行理解
- 已尝试:Transformer、RAG、LLM
- 仍需查阅:机器学习、深度学习、生成对抗网络(GAN)、自然语言处理(NLP)、强化学习
明日准备
- 阅读:教材
大模型的前世今生篇,重点是人工智能定义、发展脉络和大模型演进 - 实验:
对同一问题做 5 次模型输出对比,记录非确定性。
分析温度、上下文、指令清晰度对输出的影响。
写 LLM 风险初表:风险、触发条件、影响、可观测证据。 - 需要准备的文件/环境:本地模型、预先准备的问题
今日验收结论
通过
部分通过,需补做:
对五个验收项目的了解和认识不足,只完成了前两个,慢慢来吧
宇宙级免责声明
重要声明:本文仅供合法授权下的安全研究与教育目的!
- 合法授权:本文所述技术仅适用于已获得明确书面授权的目标或自己的靶场内系统。未经授权的渗透测试、漏洞扫描或暴力破解行为均属违法,可能导致法律后果(包括但不限于刑事指控、民事诉讼及巨额赔偿)。
- 道德约束:黑客精神的核心是建设而非破坏。请确保你的行为符合道德规范,仅用于提升系统安全性,而非恶意入侵、数据窃取或服务干扰。
- 风险自担:使用本文所述工具和技术时,你需自行承担所有风险。作者及发布平台不对任何滥用、误用或由此引发的法律问题负责。
- 合规性:确保你的测试符合当地及国际法律法规(如《计算机欺诈与滥用法案》(CFAA)、《通用数据保护条例》(GDPR)等)。必要时,咨询法律顾问。
- 最小影响原则:测试过程中应避免对目标系统造成破坏或服务中断。建议在非生产环境或沙箱环境中进行演练。
- 数据保护:不得访问、存储或泄露任何未授权的用户数据。如意外获取敏感信息,应立即报告相关方并删除。
- 免责范围:作者、平台及关联方明确拒绝承担因读者行为导致的任何直接、间接、附带或惩罚性损害责任。
安全研究的正确姿势:
- 先授权,再测试
- 只针对自己拥有或有权测试的系统
- 发现漏洞后,及时报告并协助修复
- 尊重隐私,不越界
警告:技术无善恶,人心有黑白。请明智选择你的道路。
评论
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 0x0off!